Pe scurt
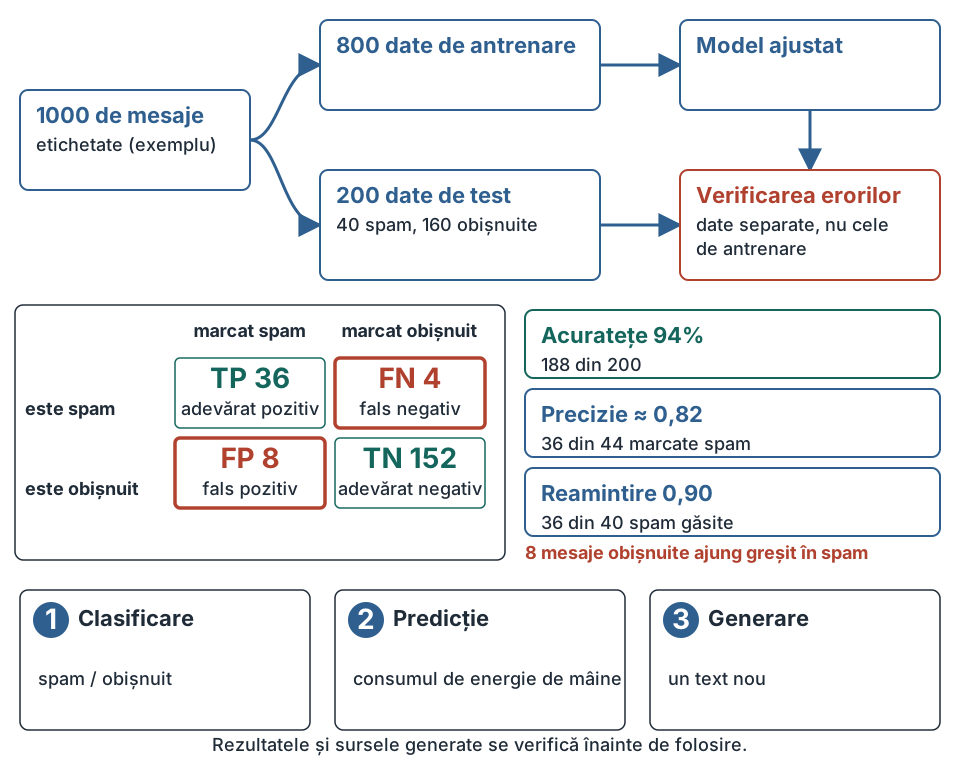
Un sistem de inteligență artificială folosește date și reguli de calcul pentru a clasifica, recomanda, prezice sau genera rezultate. În învățarea automată, un model este ajustat pe exemple; performanța lui depinde de datele alese și de modul în care este testat. Un filtru care încadrează mesajele în „spam” și „obișnuit” face clasificare. O estimare a consumului de energie de mâine este predicție. Un sistem care compune un text nou face generare. Aceste sarcini nu înseamnă că programul înțelege lumea precum o persoană.
Exemplu. O aplicație de recunoaștere a plantelor primește fotografii etichetate. Dacă exemplele conțin aproape numai frunze fotografiate la lumină puternică, identificarea unei plante fotografiate noaptea poate fi slabă. Mai multe date nu rezolvă automat problema; trebuie să fie potrivite și verificate.
În detaliu
Separă datele de antrenare de datele de test: dacă verifici modelul pe aceleași exemple pe care le-a memorat, scorul nu arată cât de bine se descurcă pe cazuri noi. O prejudecată prezentă în date poate apărea și în rezultatele modelului. Pentru un text generat, verifici nume, date, citate și linkuri înainte de folosire; o sursă inventată nu devine reală printr-o formatare credibilă. Persoanele care proiectează și folosesc sistemul răspund pentru scopul, testarea și efectele lui. Protecția datelor și drepturile de autor se aplică și conținutului introdus ori generat.
Un prompt eficient spune sarcina, contextul, constrângerile și forma răspunsului, dar claritatea promptului nu garantează adevărul rezultatului. Exemplu lucrat. Pentru o fișă de recapitulare ceri cinci întrebări despre fotosinteză, cu răspunsuri separate. Verifici apoi fiecare răspuns în materialul de studiu, elimini o întrebare care confundă oxigenul cu dioxidul de carbon și corectezi explicația înainte de a o distribui. Consumul energetic al infrastructurii este un alt criteriu când alegi dacă utilizarea sistemului aduce un beneficiu real.
Exemplu lucrat 1 — măsurarea unui filtru de mesaje. Un filtru este testat pe 200 de mesaje noi: 80 sunt spam și 120 sunt obișnuite. El identifică 72 dintre cele 80 de mesaje spam și marchează greșit ca spam 6 dintre cele 120 obișnuite, deci 114 obișnuite sunt lăsate corect. Mesajele clasificate corect sunt , iar acuratețea este . Dintre mesajele spam, filtrul prinde . Cele două cifre spun lucruri diferite: acuratețea măsoară toate deciziile, iar procentul de spam prins arată ce se întâmplă cu mesajele care contează.
Exemplu lucrat 2 — acuratețea poate înșela. Într-un set de 100 de mesaje, 95 sunt obișnuite și 5 sunt spam. Un „filtru” care răspunde mereu „obișnuit” are acuratețea , dar nu prinde niciun mesaj spam. De aceea se compară modelul și cu o regulă banală și se urmăresc separat tipurile de greșeli.
Exemplu lucrat 3 — memorare în loc de învățare. Din 1 000 de exemple, 800 servesc la antrenare și 200 la test. Un model care are 100% pe cele 800 de exemple, dar doar 70% pe cele 200, a memorat datele de antrenare și nu generalizează. Dacă scorul de 100% ar fi singurul raportat, modelul ar părea mai bun decât este.
Date și prejudecăți. Dacă toate fotografiile de antrenare provin dintr-o singură școală sau dintr-un singur anotimp, modelul poate funcționa slab în alte condiții. Înainte de utilizare se verifică de unde provin datele, cine a pus etichetele și ce cazuri lipsesc. Un sistem folosit pentru a recomanda cursuri, antrenat doar pe alegerile unui grup mic, poate ignora interesele celorlalți elevi, chiar dacă scorul de test arată bine. Deciziile care afectează oameni nu se lasă doar pe seama modelului: rezultatul se verifică de o persoană.
Greșeli frecvente
- Greșit: un model care răspunde fluent a verificat deja sursele.Corect: existența și conținutul surselor se verifică separat.
- Greșit: testarea pe exemplele de antrenare arată performanța pe date noi.Corect: testarea relevantă folosește exemple separate.
- Greșit: datele dezechilibrate nu pot influența rezultatul.Corect: distribuția datelor poate produce erori sistematice.
Testează-te pe această lecție
Lecția o citești aici, fără cont. Testele pe lecții și capitole sunt în cont, cu grile originale Didaxis și explicația fiecăreia: gratuit 10 grile pe zi, fără limită cu Premium, 49 de lei pe lună pentru fiecare copil.
Înainte și după
Surse și referințe
Redactare proprie, conform programei:
- OMEC 6930/2025, anexa 22, pp. 693–695; rocnee.eu
Documente consultate
- OMEC 6930/2025, anexa 22, TIC IX, p. 693, pct. 1.3; rocnee.eu
- Daniel Popa, Tehnologia informației și a comunicațiilor, clasa a IX-a, Intuitext, 2026, unitatea Societatea digitală, lecțiile 7–8; manuale.edu.ro
Desene: Redactare proprie (desen original), conform OMEC 6930/2025, anexa 22, TIC IX, p. 693, pct. 1.3; rocnee.eu