Pe scurt
Un caracter este o unitate de text, iar un șir este o succesiune de caractere. În C++, 'A' este un literal de tip caracter, în timp ce "A" este un literal șir. Textul "123" nu este numărul 123; nu îl poți aduna numeric fără conversie. În std::string s = "ana";, lungimea este 3 și indicii sunt 0, 1, 2.
În detaliu
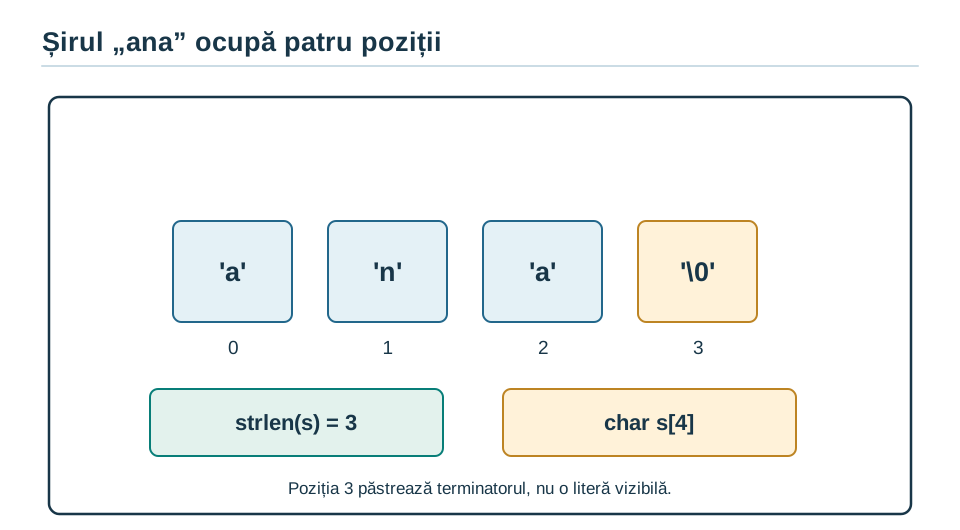
Un caracter este o unitate de text, memorată în C++ într-o variabilă de tip char ca un cod întreg; un șir de caractere este o succesiune de caractere. Literalul 'A' (între apostrofuri) este un caracter, iar "A" (între ghilimele) este un șir de lungime 1. La Bac, șirul se memorează de obicei într-un tablou de char terminat cu '\0' (caracterul nul), care marchează sfârșitul textului: în char s[4] = "ana"; pozițiile 0, 1 și 2 conțin literele, iar poziția 3 conține terminatorul. Lungimea logică a textului este numărul de caractere dinaintea terminatorului, strlen(s), adică 3, iar dimensiunea tabloului este 4. Accesul la caracter se face prin indice, s[0], s[1], ..., numerotat de la 0. Textul "123" nu este numărul 123: pentru calcule se convertește.
Codul ASCII al unor caractere: '0' are 48, 'A' are 65, 'a' are 97. Cifrele sunt consecutive ('0' până la '9', cu codurile 48–57), la fel literele mari și literele mici; diferența dintre o literă mică și majuscula ei este 32. De aceea '7' - '0' este 7, 'a' + 2 este codul lui 'c', iar comparația 'b' < 'c' este adevărată. Funcția strlen(s) din <cstring> dă lungimea logică; strcmp(a, b) dă 0 pentru șiruri egale, o valoare negativă dacă a precede b în ordine lexicografică și una pozitivă altfel.
Exemplul 1 — lungime, cod, comparație.
#include <iostream>
#include <cstring>
using namespace std;
int main() {
    char s[4] = "ana", t[4] = "are";
    cout << strlen(s) << " " << (int)'A' << " " << (strcmp(s, t) < 0);
    return 0;
}
Se afișează 3 65 1: lungimea este 3, codul lui 'A' este 65, iar "ana" precede "are", pentru că primele litere coincid, iar 'n' < 'r'. Valoarea numerică exactă a rezultatului lui strcmp nu trebuie presupusă, doar semnul ei.
Exemplul 2 — lungimea logică și dimensiunea tabloului. Pentru char s[] = "abc"; compilatorul rezervă 4 octeți: trei pentru litere și unul pentru terminator. De aceea strlen(s) este 3, sizeof(s) este 4, iar s[3] are codul 0:
char s[] = "abc";
cout << strlen(s) << ' ' << sizeof(s) << ' ' << (int)s[3];
Secvența afișează 3 4 0. Dacă tabloul ar fi declarat char s[3] = "abc";, terminatorul nu ar încăpea, iar funcțiile care așteaptă terminatorul ar citi dincolo de tablou.
Memorarea și terminatorul. Caracterele utile ocupă pozițiile , iar pe poziția se află terminatorul '\0', după care funcțiile știu unde se termină șirul. De aceea tabloul are nevoie de un element în plus față de lungimea maximă din enunț: pentru cel mult 100 de caractere, char s[101];. Parcurgerea se face cu for (i = 0; s[i] != '\0'; i++) sau până la strlen(s), calculat o singură dată, înainte de buclă.
Caracterele sunt numere. Literele mici au coduri consecutive, de la 'a' (97) la 'z' (122), la fel cele mari și cifrele. De aici vin testele uzuale: s[i] >= 'a' && s[i] <= 'z' (literă mică), strchr("aeiou", s[i]) (vocală), s[i] - 'a' + 'A' (litera mare corespunzătoare), c - '0' (cifra din caracter) și '0' + cifra (caracterul din cifră). Funcțiile toupper și tolower din cctype fac aceleași transformări.
Funcțiile din cstring.
| Ce | În C++ |
|---|---|
| Citirea unui cuvânt, a unei linii | cin >> s;, cin.getline(s, 101); |
| Copierea lui t în s, adăugarea lui t la s | strcpy(s, t);, strcat(s, t); |
| Prima apariție a unui caracter, a unui subșir | strchr(s, 'a'), strstr(s, "re"): adresa găsită sau NULL |
| Împărțirea în cuvinte | strtok(s, " "), apoi strtok(NULL, " ") |
În strcpy și strcat, șirul s trebuie să aibă destul loc. strchr și strstr întorc adresa primei apariții; poziția ei se obține scăzând adresa de început: strchr(s, 'x') - s. strtok taie șirul în cuvinte după separatorii dați și îl modifică, punând terminatori în locul separatorilor.
Ștergerea și inserarea. Ca la orice tablou, ștergerea unui caracter mută spre stânga tot ce urmează, inclusiv terminatorul. Forma scurtă strcpy(s + i, s + i + 1) apare des în rezolvări, dar standardul limbajului nu garantează rezultatul când sursa și destinația se suprapun. O buclă care mută caracterele, ca în exemplul 4, sau memmove sunt sigure.
Clasa string. C++ are și clasa string, în care lungimea se află cu s.length(), concatenarea se face cu +, iar compararea cu == și <. Programa de examen descrie șirurile prin operații (citire, afișare, concatenare, căutare, extragere, inserare, eliminare, conversii), nu printr-o bibliotecă anume, iar baremul punctează orice rezolvare corectă. Exemplele de mai jos folosesc tablourile de char, cu care lucrează funcțiile din cstring. Un exemplu scurt cu string:
#include <iostream>
#include <string>
using namespace std;

int main() {
    string a = "bac", b = "alaureat";
    string s = a + b;
    cout << s << " " << s.length() << " " << s.find("aur") << "\n";
    return 0;
}
bacalaureat 11 5
find întoarce poziția primei apariții, numărată de la 0: „aur” începe pe poziția 5.
Exemple suplimentare
Exemplul 3 — aritmetică cu caractere. Cifra '7' are valoarea numerică '7' - '0', adică 7. Litera următoare lui 'a' este (char)('a' + 1), adică 'b'. Din litera mare 'C' se obține litera mică corespunzătoare prin 'C' + ('a' - 'A'), adică 'c'. Pentru a testa dacă un caracter este literă mică se verifică c >= 'a' && c <= 'z'; pentru cifră, c >= '0' && c <= '9'.
Exemplul 4 — cifrele dintr-un șir. Se numără cifrele din textul "a1b23" și se adună valorile lor. Parcurgerea merge de la poziția 0 până la strlen(s) - 1, iar fiecare caracter este testat cu intervalul '0'..'9'.
char s[] = "a1b23";
int nr = 0, suma = 0;
for (int i = 0; i < strlen(s); i++)
    if (s[i] >= '0' && s[i] <= '9') {
        nr++;
        suma += s[i] - '0';
    }
Urmărirea: pentru caracterul 'a' nu este cifră; pentru , '1' este cifră, deci și ; pentru , 'b' este ignorat; pentru , '2' dă și ; pentru , '3' dă și . Dacă s-ar aduna direct s[i], fără scăderea lui '0', s-ar aduna codurile 49, 50 și 51, adică 150, nu cifrele 1, 2 și 3. Testul pe interval este corect pentru cifre, deoarece codurile lor sunt consecutive.
Cazul-limită este șirul vid: char s[] = ""; are lungimea logică 0 și dimensiunea tabloului 1, deoarece conține doar terminatorul, iar bucla de mai sus nu execută niciun pas pentru el.
Exemple rezolvate
Exemplul 1: numărul de vocale dintr-un text. Se citește un text cu cel mult 100 de caractere, litere mici și spații. Afișează numărul de vocale. Pentru „ana are mere” răspunsul este 6.
#include <iostream>
#include <cstring>
using namespace std;

int main() {
    char s[101];
    cin.getline(s, 101);
    int nr = 0, L = strlen(s);
    for (int i = 0; i < L; i++)
        if (strchr("aeiou", s[i]) != NULL)
            nr++;
    cout << nr << "\n";
    return 0;
}
Pentru intrarea ana are mere, programul afișează:
6
Spațiul nu se află în șirul "aeiou", deci nu este numărat. Atenție: strchr găsește și terminatorul, așa că bucla nu trebuie să ajungă la poziția .
Exemplul 2: inițiala fiecărui cuvânt, cu literă mare. Transformă în literă mare prima literă a fiecărui cuvânt. „bacalaureat la informatica” devine „Bacalaureat La Informatica”.
- Un caracter începe un cuvânt dacă este literă și este primul din șir sau se află după un spațiu.
- Litera mare se obține cu
s[i] - 'a' + 'A'.
#include <iostream>
#include <cstring>
using namespace std;

int main() {
    char s[101];
    cin.getline(s, 101);
    for (int i = 0; s[i] != '\0'; i++)
        if (s[i] >= 'a' && s[i] <= 'z' && (i == 0 || s[i - 1] == ' '))
            s[i] = s[i] - 'a' + 'A';
    cout << s << "\n";
    return 0;
}
Pentru intrarea bacalaureat la informatica, programul afișează:
Bacalaureat La Informatica
Exemplul 3: cel mai lung cuvânt, cu strtok. Afișează cel mai lung cuvânt dintr-un text, iar la lungimi egale pe primul. Pentru „ziua de azi este frumoasa”, răspunsul este „frumoasa”.
#include <iostream>
#include <cstring>
using namespace std;

int main() {
    char s[101], best[101] = "";
    cin.getline(s, 101);
    char *p = strtok(s, " ");
    while (p != NULL) {
        if (strlen(p) > strlen(best))
            strcpy(best, p);
        p = strtok(NULL, " ");
    }
    cout << best << "\n";
    return 0;
}
Pentru intrarea ziua de azi este frumoasa, programul afișează:
frumoasa
Exemplul 4: ștergerea vocalelor. Șterge toate vocalele dintr-un cuvânt. „informatica” devine „nfrmtc”.
- Când găsești o vocală pe poziția , muți spre stânga, cu o poziție, toate caracterele de după ea, inclusiv terminatorul.
- După ștergere nu treci la poziția următoare: pe poziția a ajuns un caracter nou, care trebuie verificat și el (de exemplu, două vocale consecutive).
#include <iostream>
#include <cstring>
using namespace std;

int main() {
    char s[101];
    cin >> s;
    int i = 0;
    while (s[i] != '\0')
        if (strchr("aeiou", s[i]) != NULL) {
            for (int j = i; s[j] != '\0'; j++)
                s[j] = s[j + 1];        // muta si terminatorul
        } else
            i++;
    cout << s << "\n";
    return 0;
}
Pentru intrarea informatica, programul afișează:
nfrmtc
Pentru aeroport afișează rprt: cele două vocale de la început sunt șterse una după alta, pentru că nu avansează după ștergere.
Exemplul 5: nivel de examen, cuvinte cu aceeași literă la capete. Se citește un text cu cel mult 100 de caractere, cuvinte formate din litere mici, separate prin câte un spațiu. Afișează, separate prin câte un spațiu, cuvintele care încep și se termină cu aceeași literă, sau mesajul nu exista.
strtokdă, pe rând, fiecare cuvântp. Prima literă estep[0], ultimap[strlen(p) - 1].- Un cuvânt de o literă respectă condiția (prima și ultima literă coincid).
- Pentru „ana are o casa cu cerdac”, cuvintele cerute sunt „ana”, „o” și „cerdac”.
#include <iostream>
#include <cstring>
using namespace std;

int main() {
    char s[101];
    cin.getline(s, 101);
    int gasit = 0;
    char *p = strtok(s, " ");
    while (p != NULL) {
        if (p[0] == p[strlen(p) - 1]) {
            if (gasit == 1)
                cout << " ";
            cout << p;
            gasit = 1;
        }
        p = strtok(NULL, " ");
    }
    if (gasit == 0)
        cout << "nu exista";
    cout << "\n";
    return 0;
}
Pentru intrarea ana are o casa cu cerdac, programul afișează:
ana o cerdac
Pentru bac la info afișează nu exista.
Pentru admitere
La urmărirea codului, diferențiază lungimea logică a textului de dimensiunea tabloului care îl stochează. Pentru char s[4] = "ana";, trei poziții țin literele și a patra terminatorul nul. Compararea textelor C nu se face cu == între tablouri: acesta compară adresele, nu conținutul. Pentru comparație folosește strcmp. strlen("ana") este 3, deși tabloul necesită 4 poziții. Expresia '7' - '0' transformă caracterul cifră în valoarea lui numerică. Dacă fragmentul modifică un caracter, scrie textul după fiecare modificare. Un tablou inițializat parțial, char s[10] = "ab";, are pozițiile rămase completate cu '\0': strlen(s) este 2, dar sizeof(s) este 10. Dacă un caracter din interiorul textului este înlocuit cu '\0', textul se termină acolo: din "ana", după s[1] = '\0', strlen devine 1.
Exemplu în formatul examenului. Ce se afișează în urma executării secvenței de mai jos?
char s[] = "abc";
cout << strlen(s) << ' ' << sizeof(s) << ' ' << (int)s[3];
- a)
3 3 0 - b)
3 4 0 - c)
4 4 0 - d)
3 4 99
Răspunsul corect este b). Tabloul s are 4 poziții, deoarece inițializarea cu "abc" adaugă terminatorul. strlen(s) numără caracterele dinaintea terminatorului, adică 3, sizeof(s) este 4, iar s[3] este terminatorul, cu codul 0. Varianta a) uită terminatorul în dimensiune, varianta c) îl numără în lungime, iar varianta d) confundă terminatorul cu litera 'c', al cărei cod este 99.
Urmărire pe un șir mic. Fie char s[] = "aB1"; și bucla for (int i = 0; i < strlen(s); i++) if (s[i] >= 'a' && s[i] <= 'z') s[i] = s[i] - 32;. Pentru , 'a' are codul 97, iar este codul lui 'A'. Pentru , 'B' are codul 66, în afara intervalului literelor mici, deci rămâne neschimbat. Pentru , '1' nu este literă. Șirul final este "AB1", iar lungimea lui a rămas 3.
Unde apare la examen
La Bacalaureatul la informatică, matematică-informatică, programa de examen cuprinde tipul șir de caractere, cu operatorii, procedurile și funcțiile predefinite pentru citire, afișare, concatenare, căutare, extragere, inserare, eliminare și conversii între șir și valoare numerică (anexa 2 la OMECTS 4800/2010). La sesiunea din iunie–iulie 2026, al doilea exercițiu al Subiectului al III-lea (10 puncte) a cerut un program C/C++ care citește un cuvânt și verifică o proprietate a literelor aflate pe poziții consecutive. Formatul descris este cel din 2026; potrivit proiectului de ordin pentru Bacalaureatul 2027, programa rămâne aceeași.
Pe programa școlară veche, șirurile de caractere sunt la clasa a XI-a, împreună cu structurile de date neomogene (OMECI 5099/2009). Pe programa nouă, aplicată din 2027–2028, ele trec în clasa a X-a, cu clasa str din Python.
Greșeli frecvente
- Greșit:
'A'și"A"sunt același lucru.Corect: primul este un caracter, al doilea un șir de lungime 1, cu terminator. - Greșit:
strlen("ana")este 4, pentru că tabloul are 4 poziții.Corect:strlennumără doar caracterele dinaintea terminatorului, deci 3. - Greșit: două șiruri C se compară cu
==.Corect:==compară adresele; conținutul se compară custrcmp. - Greșit:
'A'și"A"au același tip.Corect: primul este caracter, al doilea este șir. - Greșit:
"123"este automat întregul 123.Corect: este text. - Greșit: un tablou
char[3]poate stoca șirul C"ana"complet.Corect: este nevoie și de poziția terminatorului; pentru 100 de caractere se declarăchar s[101], altfel terminatorul se scrie în afara tabloului. - Greșit:
cin >> scitește un text cu spații.Corect: citește doar primul cuvânt; pentru o linie întreagă se foloseștecin.getline(s, 101). - Greșit:
a == bcompară conținutul a două tablouri dechar, iars = tcopiază un șir.Corect:a == bcompară adrese, deci se foloseștestrcmp(a, b) == 0; un tablou nu se poate atribui, deci copierea se face custrcpy(s, t). - Greșit:
strlen(s), calculat o dată înainte de o ștergere, rămâne valabil.Corect: după o ștergere lungimea se schimbă; fie o recalculezi, fie parcurgi până la terminator, ca în exemplul 4. - Greșit: după ștergerea de pe poziția se trece la .Corect: se sare peste caracterul care a venit pe poziția .
Testează-te pe această lecție
Lecția o citești aici, fără cont. Testele pe lecții și capitole sunt în cont, cu grile originale Didaxis și explicația fiecăreia: gratuit 10 grile pe zi, fără limită cu Premium, 49 de lei pe lună pentru fiecare copil.
Înainte și după
Întrebări frecvente
Cum citesc în C++ un text care conține spații?
Ce returnează strcmp?
Cum transform o cifră-caracter în număr?
Surse și referințe
Redactare proprie, conform programei:
- OMECI 5099/2009, anexa 5, Informatică, p. 4–5, clasa X intensiv; rocnee.eu
- OMECI 5099/2009, anexa 5, Informatică, p. 4–5, clasa XI; plan de încadrare: OMEC 7723/2024, anexa 2, tabelele 1–25, legislatie.just.ro; filiera tehnologică: OMEC 7724/2024, anexa 4, tabelul calificării, legislatie.just.ro
- UNSTPB, Regulament admitere licență 2026, Anexa II-1.2 p. Anx II-14 și Anexa XI-3 p. Anx XI-6–7 (PDF p. 64, 120–121); admitere.pub.ro
- OMECTS 4800/2010, anexa 2, Informatică, p. 3–4; edu.ro
Documente consultate
- UNSTPB, admitere 2026, anexa XI-3, p. Anx XI-6–7
- Programa școlară de informatică, clasa a XI-a (OMECI 5099/2009, anexa 5), CNCE; rocnee.eu
- Programa de bacalaureat la informatică, matematică-informatică (anexa 2 la OMECTS 4800/2010), Ministerul Educației, p. 3–4; edu.ro
- Subiectele și baremele Bacalaureatului 2026; subiecte2026.edu.ro
- Proiect de ordin privind organizarea și desfășurarea Bacalaureatului, calendar 2027, Ministerul Educației; edu.ro
Desene: Redactare proprie (desen original), conform Programa școlară de informatică, clasa a XI-a (OMECI 5099/2009, anexa 5), CNCE; rocnee.eu